
Ujnotes — CC0 1.0
जेमिनी, ओपनएआई, क्लॉड, ग्रोक, डीपसीक और प्रमुख फ्रंटियर एआई प्रदाताओं के आधिकारिक मूल्य निर्धारण केंद्र, मॉडल कार्ड और टोकन लागत संरचना।
एलएलएम मूल्य निर्धारण क्या है?
लार्ज लैंग्वेज मॉडल (एलएलएम) मूल्य निर्धारण न्यूरल नेटवर्क पर इनफ़रेंस चलाने की गणना-आधारित लागत है। पारंपरिक सॉफ़्टवेयर के विपरीत जो स्थायी लाइसेंस या निश्चित मासिक शुल्क पर बिकता है, एलएलएम एपीआई केवल उपयोग की गई कंप्यूट क्षमता के लिए शुल्क लेते हैं, जिसे टोकन (tokens) में मापा जाता है। एक टोकन आमतौर पर एक अंग्रेज़ी शब्द के लगभग तीन-चौथाई हिस्से के बराबर होता है।
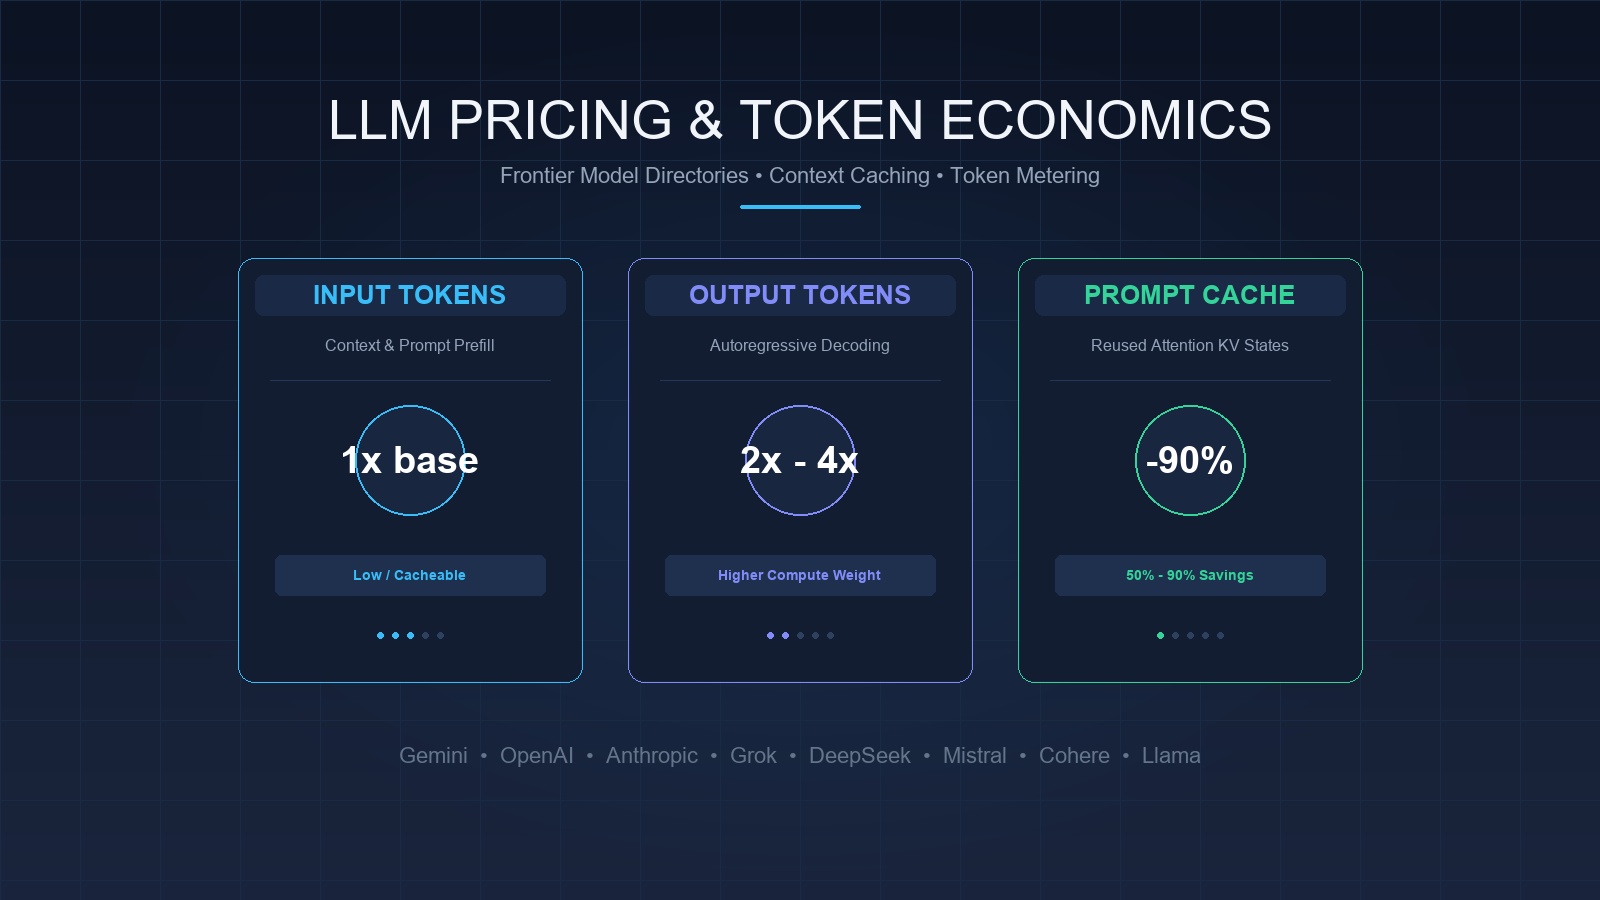
एपीआई को भेजे गए प्रत्येक प्रॉम्प्ट में इनपुट टोकन खर्च होते हैं जो संदर्भ को संसाधित करते हैं, और मॉडल द्वारा उत्पन्न प्रत्येक शब्द, वर्ण या विराम चिह्न आउटपुट टोकन के रूप में मापा जाता है। जीपीयू टेन्सर कोर पर नए पाठ को क्रमिक रूप से उत्पन्न करने में अधिक गणना लगती है, इसलिए आउटपुट टोकन आमतौर पर इनपुट टोकन की तुलना में दो से चार गुना अधिक महंगे होते हैं।
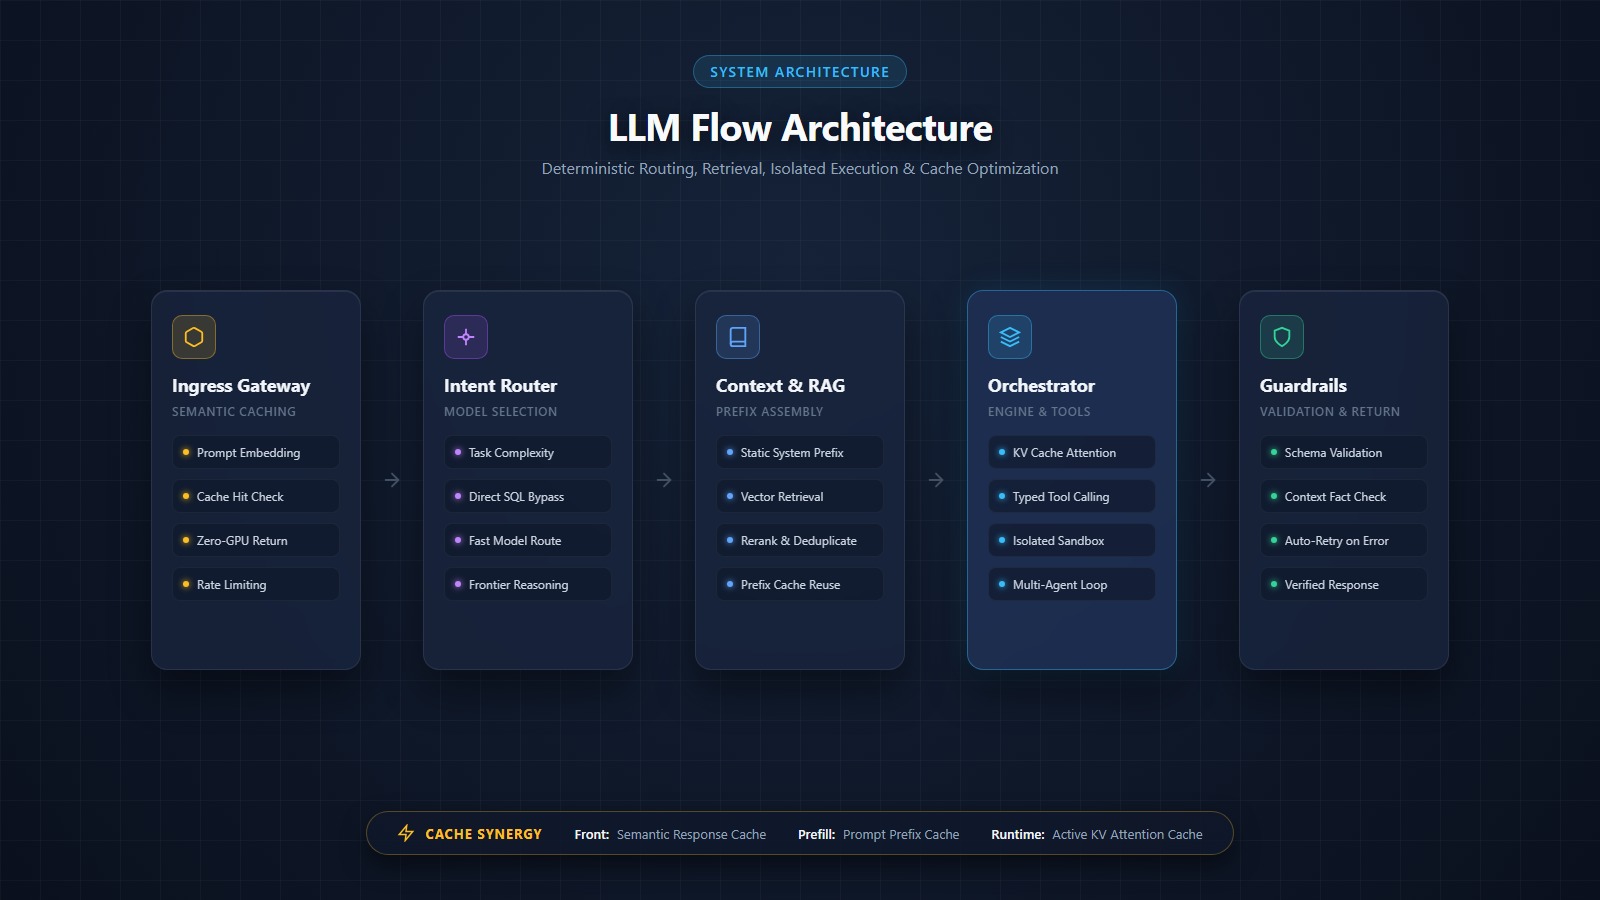
आधुनिक मूल्य निर्धारण मॉडल में वास्तविक समय के कॉल, पहले से गणना किए गए प्रॉम्प्ट प्रीफ़िक्स (कैशिंग), पृष्ठभूमि बैच अनुरोध, और छिपे हुए तर्क टोकन (रीज़निंग टोकन) के बीच भी अंतर किया जाता है।
मूल्य निर्धारण संरचनाओं में क्या अंतर है?
विभिन्न प्रदाताओं के बीच मॉडल लागत का मूल्यांकन करते समय पाँच मुख्य पहलुओं को समझना आवश्यक है:
- इनपुट बनाम आउटपुट टोकन: इनपुट टोकन में प्रॉम्प्ट, सिस्टम निर्देश, उदाहरण और संदर्भ शामिल होते हैं। आउटपुट टोकन में मॉडल द्वारा उत्पन्न प्रतिक्रियाएँ और संरचित आउटपुट शामिल होते हैं।
- रीज़निंग टोकन (Reasoning Tokens): फ्रंटियर रीज़निंग मॉडल (जैसे ओपनएआई का o1/o3 और डीपसीक-R1) उत्तर देने से पहले आंतरिक विचार प्रक्रिया उत्पन्न करते हैं। इन आंतरिक टोकनों का बिल भी आउटपुट दर पर लिया जाता है, जिससे कुल लागत बढ़ जाती है।
- प्रॉम्प्ट और संदर्भ कैशिंग (Prompt Caching): जब कई अनुरोध एक समान प्रॉम्प्ट प्रीफ़िक्स (जैसे बड़े सिस्टम निर्देश या दस्तावेज़) साझा करते हैं, तो इंजन पहले से गणना किए गए की-वैल्यू (KV) अटेंशन स्टेट्स को सहेजते हैं। कैश्ड टोकन के पुन: उपयोग से इनपुट लागत में 50% से 90% की कमी आती है।
- संदर्भ सीमा टियर (Context Tiers): कई मॉडल मानक सीमा (जैसे 128,000 टोकन) से अधिक लंबे प्रॉम्प्ट के लिए उच्च दरें लागू करते हैं, क्योंकि बड़े अटेंशन मैट्रिक्स को बनाए रखने के लिए अधिक जीपीयू मेमोरी बैंडविड्थ की आवश्यकता होती है।
- बैच प्रोसेसिंग छूट (Batch API): जो कार्य तुरंत वास्तविक समय में आवश्यक नहीं होते और 24 घंटे के भीतर संसाधित किए जा सकते हैं, उन पर स्वचालित रूप से 50% तक की छूट मिलती है।
प्रमुख प्रदाताओं के मूल्य निर्धारण और मॉडल निर्देशिकाएँ
अग्रणी एआई प्रयोगशालाएँ आधिकारिक मूल्य निर्धारण पोर्टल, डेवलपर कंसोल और मॉडल कार्ड बनाए रखती हैं जहाँ विनिर्देश और दरें प्रकाशित की जाती हैं:
- गूगल डीपमाइंड और जेमिनी (Gemini): जेमिनी परिवार के सभी विनिर्देशों और बेंचमार्क के लिए आधिकारिक DeepMind Model Cards देखें। डेवलपर दरों और कैशिंग छूट की जानकारी Google AI Studio Pricing पर उपलब्ध है, जबकि एंटरप्राइज़ दरें Google Cloud Vertex AI Pricing पर प्रबंधित होती हैं। मॉडल क्षमताओं की सूची Gemini API Models Documentation में है।
- ओपनएआई (OpenAI): GPT-4o, GPT-4o mini, o1, o1-mini और o3-mini की प्रति मिलियन टोकन दरें OpenAI API Pricing Page पर उपलब्ध हैं। संदर्भ सीमाओं और मॉडल विवरण के लिए OpenAI Platform Models Overview देखें।
- एंथ्रोपिक क्लॉड (Anthropic Claude): Claude 3.5 Sonnet, Claude 3.5 Haiku और Claude 3 Opus की आधिकारिक दरें Anthropic Pricing Hub पर हैं। प्रॉम्प्ट कैशिंग (90% रीड छूट) और संदेश बैचिंग का विवरण Claude Models Overview & Rates में दर्ज है।
- एक्सएआई ग्रोक (xAI Grok): Grok 2 और Grok Vision की एपीआई दरें xAI API Documentation & Pricing पर सूचीबद्ध हैं। उपयोग और बिलिंग xAI Developer Console से प्रबंधित होती है।
- डीपसीक (DeepSeek): DeepSeek-V3 और DeepSeek-R1 की लागत DeepSeek API Pricing Page पर प्रकाशित है, जिसमें उद्योग की सबसे प्रतिस्पर्धी इनपुट और कैश्ड दरें शामिल हैं। वास्तुकला विवरण DeepSeek API Documentation में देखा जा सकता है।
ओपन-वेट्स और एंटरप्राइज़ प्लेटफ़ॉर्म
ओपन-वेट्स निर्माता और क्लाउड कंपनियाँ प्रबंधित होस्टिंग और मॉडल कैटलॉग प्रदान करती हैं:
- मिस्ट्रल एआई (Mistral AI): Mistral Large, Mistral Small और Codestral की व्यावसायिक दरें Mistral AI Pricing Directory और गाइड Mistral Models Platform Guide पर उपलब्ध हैं।
- कोहियर (Cohere): Command R+, Command R और Rerank की कीमतें Cohere Pricing पर और तकनीकी दस्तावेज़ Cohere Models Documentation पर हैं।
- मेटा लामा (Meta Llama): Llama 3.3 और 3.1 के ओपन मॉडल Meta Llama Official Hub पर हैं, और मॉडल कार्ड Meta Model Cards & Prompt Formats में हैं।
- अमेज़ॅन बेडरॉक (Amazon Bedrock): एडब्ल्यूएस पर प्रबंधित मॉडल होस्टिंग की दरें Amazon Bedrock Pricing पर सूचीबद्ध हैं।
- माइक्रोसॉफ्ट अज़्योर एआई (Microsoft Azure AI): अज़्योर ओपनएआई और सर्वरलेस मॉडल की कीमतें Azure AI Services Pricing पर उपलब्ध हैं।
डायनामिक मूल्य राउटर और विशेष इनफ़रेंस इंजन
कई मॉडलों के बीच स्वचालित रूटिंग और तुलनात्मक मूल्य देखने के लिए तृतीय-पक्ष प्रदाता उपयोगी हैं:
- ओपनराउटर (OpenRouter): 300 से अधिक मॉडलों का वास्तविक समय मूल्य सूचकांक OpenRouter Models Directory पर बनाए रखता है।
- ग्रॉक (Groq): कस्टम एलपीयू हार्डवेयर पर अत्यधिक तेज़ इनफ़रेंस दरें Groq Pricing पर प्रदान करता है।
- टुगेदर एआई (Together AI): ओपन मॉडलों के लिए सर्वरलेस टोकन दरें Together AI Pricing पर उपलब्ध हैं।
- फ़ायरवर्क्स एआई (Fireworks AI): त्वरित फ़ंक्शन कॉलिंग और इनफ़रेंस दरें Fireworks AI Pricing पर सूचीबद्ध हैं।
लागत का अनुमान और प्रबंधन कैसे करें
उत्पादन प्रणालियों में खर्च को नियंत्रित करने के लिए व्यावहारिक नियम:
- कार्य की जटिलता के अनुसार मॉडल चुनें: सामान्य वर्गीकरण या निष्कर्षण के लिए महंगे मॉडलों का उपयोग करने से बचें; नियमित कार्यों के लिए छोटे मॉडल (Gemini Flash, GPT-4o mini, Claude Haiku) चुनें।
- प्रॉम्प्ट कैशिंग के अनुकूल संरचना बनाएँ: अपरिवर्तनीय सिस्टम निर्देशों और दस्तावेज़ों को प्रॉम्प्ट की शुरुआत में रखें, और गतिशील चर हमेशा अंत में रखें।
- पृष्ठभूमि कार्यों के लिए बैच एपीआई का उपयोग करें: गैर-तात्कालिक कार्यों के लिए बैच अनुरोध भेजकर 50% तक लागत बचाएँ।
- रीज़निंग टोकन की सीमा निर्धारित करें: रीज़निंग मॉडलों को अनियंत्रित टोकन खर्च करने से रोकने के लिए अधिकतम टोकन सीमा तय करें।
- आधिकारिक मूल्य पृष्ठों की नियमित समीक्षा करें: कंप्यूट क्षमता में सुधार के साथ कीमतें अक्सर बदलती हैं; बड़े पैमाने परिनियोजन से पहले आधिकारिक डैशबोर्ड अवश्य देखें।
एआई प्रकटीकरण: एआई (ChatGPT) की सहायता से लिखा गया। आपसे अनुरोध है कि त्रुटियों और चूकों की ओर ध्यान दिलाएँ।